Si trabajas en marketing digital, es probable que en los últimos meses hayas visto mencionado el archivo llms.txt en artículos sobre SEO, IA generativa o WordPress. La pregunta que nos hacen la mayoría de clientes es sencilla: ¿qué es exactamente, y merece la pena implementarlo?
La respuesta corta: llms.txt es un archivo de texto en formato Markdown, alojado en la raíz de una web, que ofrece a los modelos de lenguaje y a los agentes de IA un resumen curado del contenido más relevante del sitio. No es un estándar oficial de internet, no lo exige ningún buscador y no sustituye a robots.txt ni a sitemap.xml. Es, más bien, una convención que ha ido ganando adopción desde 2024 y que en 2026 sigue evolucionando.
En este artículo vamos a explicar, con el máximo rigor posible, qué es llms.txt, cómo funciona, qué relación real tiene con ChatGPT, Gemini, Claude y otros sistemas de IA, cuál es la postura oficial de Google al respecto, y cómo lo estamos implementando en Cinpy en proyectos reales como ServiAlarma, utilizando Rank Math sobre WordPress.
Qué es llms.txt y de dónde viene
El archivo llms.txt fue propuesto en septiembre de 2024 por Jeremy Howard, cofundador de Answer.AI y fast.ai, como una forma de facilitar que los agentes de IA entendieran una web sin tener que procesar el HTML completo de cada página. La idea de partida era simple: las páginas web están pensadas para personas, con menús, publicidad y JavaScript, y ese «ruido» dificulta que un modelo de lenguaje extraiga la información relevante de forma eficiente.
La propuesta original ha evolucionado. En agosto de 2026, la especificación publicada en llmstxt.org se encuentra en su versión 2, que mantiene la misma estructura básica del archivo pero añade recomendaciones adicionales, como ofrecer versiones en Markdown de las páginas enlazadas (añadiendo .md a la URL) y el uso de cabeceras de enlace (rel="alternate" y rel="describedby") para que los clientes automatizados encuentren más fácilmente esas versiones. Conviene tener presente que se trata de una propuesta de comunidad, mantenida en un repositorio abierto en GitHub, y no de un estándar formal ratificado por un organismo como el W3C o la IETF.
Es importante partir de esta idea porque marca todo lo demás: llms.txt es una convención voluntaria, no una obligación técnica ni una directiva que los sistemas de IA estén forzados a respetar.
Cómo funciona: la estructura del archivo
El archivo se publica como texto plano en la raíz del dominio, en tudominio.com/llms.txt, aunque la propia especificación permite también ubicarlo en subcarpetas (por ejemplo tudominio.com/docs/llms.txt) para cubrir solo una sección del sitio.
Su estructura, según la especificación vigente, es la siguiente, en este orden:
- Un encabezado H1 con el nombre del proyecto o del sitio. Es el único elemento obligatorio de todo el archivo.
- Una cita (blockquote) con un resumen breve de qué es el sitio o el proyecto.
- Bloques de texto libre (sin encabezados) con información adicional de contexto.
- Secciones delimitadas por encabezados H2, cada una con una lista de enlaces en formato
[nombre](url): descripción. - Opcionalmente, una sección llamada «Optional», reservada por convención para enlaces secundarios que un agente puede omitir si necesita ahorrar contexto.
Un esqueleto genérico sería algo así:
# Nombre de la empresa

> Descripción breve de una línea sobre qué hace la empresa

Contexto adicional relevante que no cabe en el resumen.

## Servicios

- [Página de servicio A](https://ejemplo.com/servicio-a): qué resuelve esta página
- [Página de servicio B](https://ejemplo.com/servicio-b): qué resuelve esta página

## Optional

- [Contenido secundario](https://ejemplo.com/contenido): enlaces que se pueden omitir
No hay validación obligatoria, no hay una lista cerrada de campos y no existe una autoridad central que certifique si un archivo «cumple» o no la especificación al cien por cien. Esto da bastante libertad, pero también explica por qué encontramos implementaciones muy dispares entre sitios.
Diferencias entre llms.txt, robots.txt y sitemap.xml
Este es, probablemente, el punto donde más confusión existe, y merece una aclaración directa: llms.txt no es una directiva de rastreo. No permite ni bloquea el acceso de ningún crawler, no sustituye las reglas de robots.txt y no tiene ningún mecanismo de «allow» o «disallow». Confundirlo con «el robots.txt de la IA» lleva a expectativas equivocadas.
Cada archivo cumple una función distinta:
| Archivo | Finalidad | Dirigido a | ¿Controla el acceso? |
|---|---|---|---|
| robots.txt | Indicar qué rutas puede o no rastrear un crawler | Bots de buscadores y otros rastreadores automatizados | Sí, mediante reglas allow/disallow |
| sitemap.xml | Listar todas las URLs indexables del sitio para facilitar su descubrimiento | Motores de búsqueda | No, es solo un listado |
| llms.txt | Ofrecer un resumen curado y jerarquizado del contenido más relevante | Modelos de lenguaje y agentes de IA que decidan leerlo | No, es un documento informativo |
Una forma sencilla de verlo: el sitemap le dice a un buscador «aquí está todo lo que tengo», robots.txt le dice «esto puedes tocarlo y esto no», y llms.txt le dice a quien decida leerlo «de todo lo que tengo, esto es lo importante y así lo entenderás mejor». Son documentos complementarios, no competidores, y de hecho el propio llms.txt puede incluir un enlace a tu sitemap XML, algo que veremos más adelante en el caso de ServiAlarma.
Qué relación tiene llms.txt con los modelos de lenguaje y los agentes de IA
Aquí es donde conviene ser especialmente cuidadosos, porque es la parte que más se presta a promesas exageradas.
Lo que sí está documentado es que algunos laboratorios de IA publican su propio archivo llms.txt para su documentación técnica: por ejemplo, tanto OpenAI como Anthropic y Google publican un llms.txt para sus portales de documentación para desarrolladores, pensado para que los agentes de codificación (como los que se integran en editores de código) encuentren referencias de API sin tener que parsear HTML. Es un caso de uso real, pero muy concreto: documentación técnica leída por agentes de desarrollo, no el asistente conversacional de cara al usuario final leyendo la web de cualquier empresa.
Lo que no está confirmado, a día de hoy, es que ChatGPT, Gemini, Claude o Perplexity consulten de forma sistemática el llms.txt de sitios web de terceros al generar una respuesta para un usuario. La documentación pública de OpenAI sobre sus rastreadores utiliza robots.txt para gestionar el acceso de sus bots y no presenta llms.txt como mecanismo de control, señal de ranking o señal de citación. Existen menciones anecdóticas y no verificadas sobre algún sistema que en ocasiones solicita el archivo, pero no hay una declaración oficial de ningún proveedor que confirme un uso consistente y generalizado del archivo en producción para responder preguntas de usuarios.
Por eso conviene separar bien varios conceptos que se mezclan a menudo:
- Facilitar la comprensión: darle a un sistema un resumen ordenado, si decide leerlo.
- Ser rastreado: que un bot visite tus páginas.
- Ser indexado: que un sistema guarde y organice tu contenido para uso posterior.
- Ser citado: que una respuesta generativa mencione tu marca o enlace tu página.
- Posicionar orgánicamente: aparecer arriba en un buscador tradicional.
Tener un llms.txt puede, como máximo, ayudar en el primer punto, y solo en los sistemas que efectivamente decidan soportarlo. No garantiza ninguno de los otros cuatro. Quien te venda llms.txt como «la forma de aparecer en ChatGPT» no está siendo preciso con lo que hoy se puede demostrar. Si quieres profundizar en qué palancas sí tienen impacto demostrable en cómo te entienden estos sistemas, lo desarrollamos con más detalle en nuestro artículo sobre SEO técnico para ChatGPT.
Sí es reseñable, como dato de contexto sobre hacia dónde va la infraestructura del ecosistema, que Chrome ha incorporado en Lighthouse una comprobación relacionada con llms.txt dentro de sus auditorías de «agentic browsing» (navegación por agentes). Es un desarrollo interesante, pero pertenece al terreno de las herramientas para agentes que navegan páginas, no al de las señales de ranking del buscador Google, que trataremos justo a continuación.
La postura oficial de Google sobre llms.txt
Este es, probablemente, el punto más importante del artículo, porque es donde se producen más afirmaciones incorrectas en contenidos sobre este tema.
Google actualizó en junio de 2026 su guía oficial de optimización para funciones de IA en Search, añadiendo un apartado específico de aclaración sobre archivos como llms.txt. La documentación es clara en varios puntos:
- Google Search no necesita un archivo llms.txt para mostrar una web en sus resultados, incluidas sus funciones generativas como AI Overviews o AI Mode.
- Google Search no utiliza llms.txt como señal de ranking. No es un factor de posicionamiento, ni positivo ni negativo.
- No tenerlo no penaliza a una web de ninguna forma.
- Google reconoce que una web puede seguir manteniendo su archivo llms.txt para otros servicios o sistemas que decidan utilizarlo, aunque eso quede fuera del ámbito de Google Search.
Esta posición no es nueva ni improvisada: representantes de Google como Gary Illyes ya habían comentado en encuentros públicos de Search Central, con anterioridad a esa actualización, que Google no da soporte a llms.txt y no tiene planes de hacerlo, insistiendo en que el posicionamiento en las funciones de IA de Search depende de los mismos fundamentos que el SEO tradicional: contenido útil, rastreable y bien estructurado.
La consecuencia práctica es directa: si tu objetivo es mejorar el posicionamiento en Google, incluyendo AI Overviews o AI Mode, llms.txt no es la palanca que lo va a conseguir. Puedes mantenerlo por otros motivos —coherencia de marca, documentación para agentes, cara a otros sistemas de IA—, pero no lo presentes ni lo vendas como un truco de SEO para Google.
¿Entonces ayuda o no al SEO y al GEO?
La forma correcta de plantearlo es esta: llms.txt no es una técnica de posicionamiento por sí sola, sino una pieza de infraestructura opcional dentro de una estrategia más amplia de SEO y GEO (Generative Engine Optimization). Si quieres ver cómo trabajamos esa estrategia de forma completa, puedes consultar nuestro servicio de Agencia GEO.
El GEO —la disciplina que busca que las respuestas generativas de sistemas de IA citen y representen bien a una marca— sigue apoyándose, hoy, en los mismos fundamentos que el SEO tradicional, ampliados con algunos matices propios de cómo funcionan estos sistemas:
- Contenido útil, original y que responda realmente a la intención de búsqueda.
- Arquitectura web clara y una jerarquía de encabezados coherente.
- Buena indexabilidad técnica (sin bloqueos accidentales, sin contenido duplicado).
- Autoridad temática construida con contenido consistente en el tiempo.
- Estructura semántica clara y datos estructurados (schema) cuando aporten valor.
- Contenido actualizado, especialmente en temas sensibles a cambios.
- Una entidad de marca reconocible y coherente en toda la web y fuera de ella.
- Enlaces y menciones desde fuentes relevantes.
- Accesibilidad técnica: velocidad, rastreo limpio, buena experiencia móvil.
- Experiencia y conocimiento demostrables (lo que en SEO conocemos como E-E-A-T).
- Información verificable, con datos y fuentes que se puedan comprobar.
- Presencia en medios, directorios y fuentes que los sistemas de IA suelen consultar.
Un archivo llms.txt puede complementar todo esto ofreciendo un resumen ordenado para quien lo lea, pero no sustituye ninguno de estos pilares. Publicar un llms.txt en una web con contenido pobre, mal estructurada o técnicamente descuidada no va a compensar esas carencias.
Qué puede y qué no puede hacer llms.txt hoy
Para cerrar cualquier ambigüedad, lo resumimos de forma directa:
Sí puede:
- Ofrecer un resumen curado y ordenado de tu web a quien decida consultarlo.
- Ahorrar contexto a un agente de IA que sí lo soporte, evitando que tenga que interpretar HTML completo.
- Servir de documento de referencia para agentes de desarrollo si publicas documentación técnica.
- Reforzar la coherencia de cómo se describe tu marca, al ser un texto que tú mismo controlas y redactas.
No puede (al menos, no de forma demostrada en 2026):
- Garantizar que ChatGPT, Gemini, Claude o cualquier otro sistema lo lea o lo utilice.
- Mejorar tu posicionamiento en Google, ni en Search tradicional ni en AI Overviews o AI Mode.
- Sustituir a robots.txt como mecanismo de control de acceso.
- Sustituir al sitemap.xml como listado completo de URLs indexables.
- Compensar una web con problemas de contenido, estructura o rastreo.
- Garantizar que tu marca sea citada en una respuesta generativa.
¿Cuándo tiene sentido implementarlo y cuándo no es prioritario?
Dado que el coste de implementación es bajo —sobre todo si usas un plugin como Rank Math— y el riesgo también lo es, en muchos casos tiene sentido incorporarlo como una mejora más dentro de un plan de trabajo, sin urgencia ni prioridad máxima.
Tiene especial sentido si:
- Publicas documentación técnica, APIs o recursos que herramientas de desarrollo con IA podrían necesitar consultar.
- Quieres tener controlado y curado cómo se describe tu negocio en un formato que tú mismo redactas, de cara a un ecosistema que sigue evolucionando.
- Ya dispones de una base sólida de SEO técnico y contenido, y llms.txt es una pieza más dentro de un plan de GEO, no la única.
Probablemente no sea prioritario si:
- Tu web todavía tiene problemas de indexabilidad, contenido duplicado o arquitectura básica sin resolver: ahí está el verdadero margen de mejora.
- Esperas resultados medibles a corto plazo en tráfico o posicionamiento por el simple hecho de publicarlo.
- No tienes capacidad de mantenerlo actualizado; un llms.txt desactualizado, con enlaces rotos o contenido obsoleto, puede ser peor que no tenerlo.
Cómo crear llms.txt en WordPress con Rank Math
Si tu web funciona con WordPress y usas Rank Math SEO, la implementación es sencilla, ya que el propio plugin incorpora un módulo dedicado según su documentación oficial vigente. Los pasos, resumidos, son estos:
1. Activar el módulo LLMS Txt. Desde el panel de WordPress, entra en Rank Math SEO → Dashboard y localiza el módulo llamado LLMS Txt. Activa el interruptor correspondiente. Si no lo ves, es probable que necesites actualizar el plugin a su versión más reciente.
2. Abrir la configuración. Una vez activado, accede a Rank Math SEO → General Settings → Edit llms.txt (o al icono de ajustes que aparece junto al propio módulo). Por defecto, el archivo estará vacío hasta que lo configures.
3. Seleccionar los tipos de contenido. Elige qué post types quieres incluir —normalmente entradas de blog y páginas—. Rank Math generará automáticamente el título, la URL y una breve descripción obtenida por defecto del extracto del contenido.
4. Seleccionar taxonomías (opcional). Puedes incluir también categorías o etiquetas, que se listarán junto con su URL.
5. Establecer el límite de contenidos. Rank Math permite fijar cuántos posts o términos se incluyen como máximo (el valor por defecto es 100). Aquí conviene aplicar criterio editorial, y volveremos sobre esto en el siguiente apartado.
6. Añadir contenido adicional. Existe un campo para añadir manualmente enlaces o texto que no salgan de forma automática del listado de post types, por ejemplo enlaces a páginas clave que quieras destacar de forma prioritaria.
7. Guardar y previsualizar. Al guardar los cambios, Rank Math ofrece un enlace de vista previa para comprobar cómo queda el archivo final, accesible públicamente en tudominio.com/llms.txt.
Un matiz importante: Rank Math no escribe un archivo físico en el servidor, sino que sirve el contenido de forma dinámica cuando alguien visita esa URL. En la práctica, para quien lo consulta, el resultado es indistinguible de un archivo estático.
LLMS Txt
Utiliza un archivo llms.txt personalizado para orientar a los modelos de IA con publicaciones, términos y el contenido más importante de tu sitio web.
Qué contenido merece estar en tu llms.txt (y qué no)
Que Rank Math permita generar el listado automáticamente a partir de tus post types no significa que lo mejor sea volcar ahí toda la web sin criterio. Un archivo con cientos de URLs casi idénticas —por ejemplo, decenas de páginas locales con textos muy parecidos entre sí— pierde precisamente lo que hace útil a llms.txt: ser un resumen curado, no un volcado completo. Para eso ya existe el sitemap.xml.
Antes de dar por buena la configuración automática, es razonable revisar:
- Que las páginas incluidas representen de verdad lo esencial del negocio (servicios principales, contenido de referencia, información de contacto y confianza).
- Que las descripciones generadas automáticamente, obtenidas por defecto del extracto de cada página o entrada, sean claras y no genéricas.
- Que no haya contenido obsoleto, duplicado o de muy baja calidad ocupando espacio en el listado.
- Si el sitio tiene un volumen alto de páginas similares entre sí (por ejemplo, páginas por ciudad o por variante de producto), valorar si conviene ajustar el límite de contenidos o usar el campo de contenido adicional para priorizar manualmente las páginas más representativas.
Caso práctico: cómo lo hemos implementado en ServiAlarma
En Cinpy ya lo estamos incorporando en determinados proyectos, y uno de los ejemplos que mejor ilustra el proceso es ServiAlarma, empresa especializada en alarmas y sistemas de seguridad para hogares y negocios.
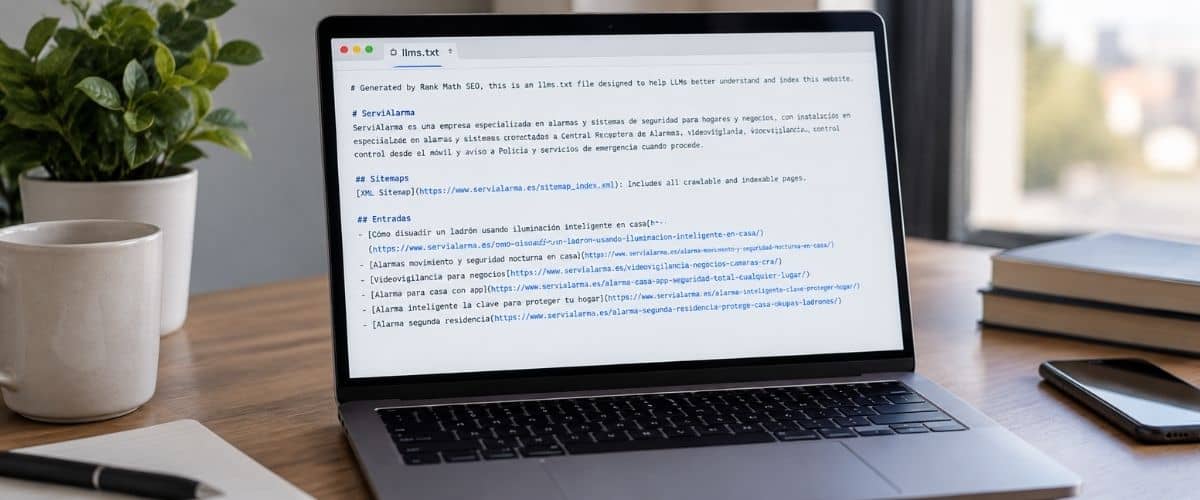
En el caso de ServiAlarma, la implementación se ha realizado directamente con el módulo LLMS Txt de Rank Math sobre WordPress, sin desarrollo a medida. El archivo público, disponible en servialarma.es/llms.txt, muestra de forma explícita que ha sido generado por Rank Math SEO, e incluye:
- Un encabezado H1 con el nombre de la empresa y una descripción de una línea sobre su actividad (alarmas y sistemas de seguridad conectados a Central Receptora de Alarmas, videoverificación y videovigilancia).
- Una sección de sitemap, con un enlace directo al sitemap XML del sitio, para que quien lea el archivo pueda acceder al listado completo de páginas si lo necesita.
- Una sección de entradas de blog, con el título, la URL y una breve descripción de cada artículo, generada a partir del contenido de cada entrada.
- Una sección de páginas, con la misma lógica aplicada a las páginas del sitio.
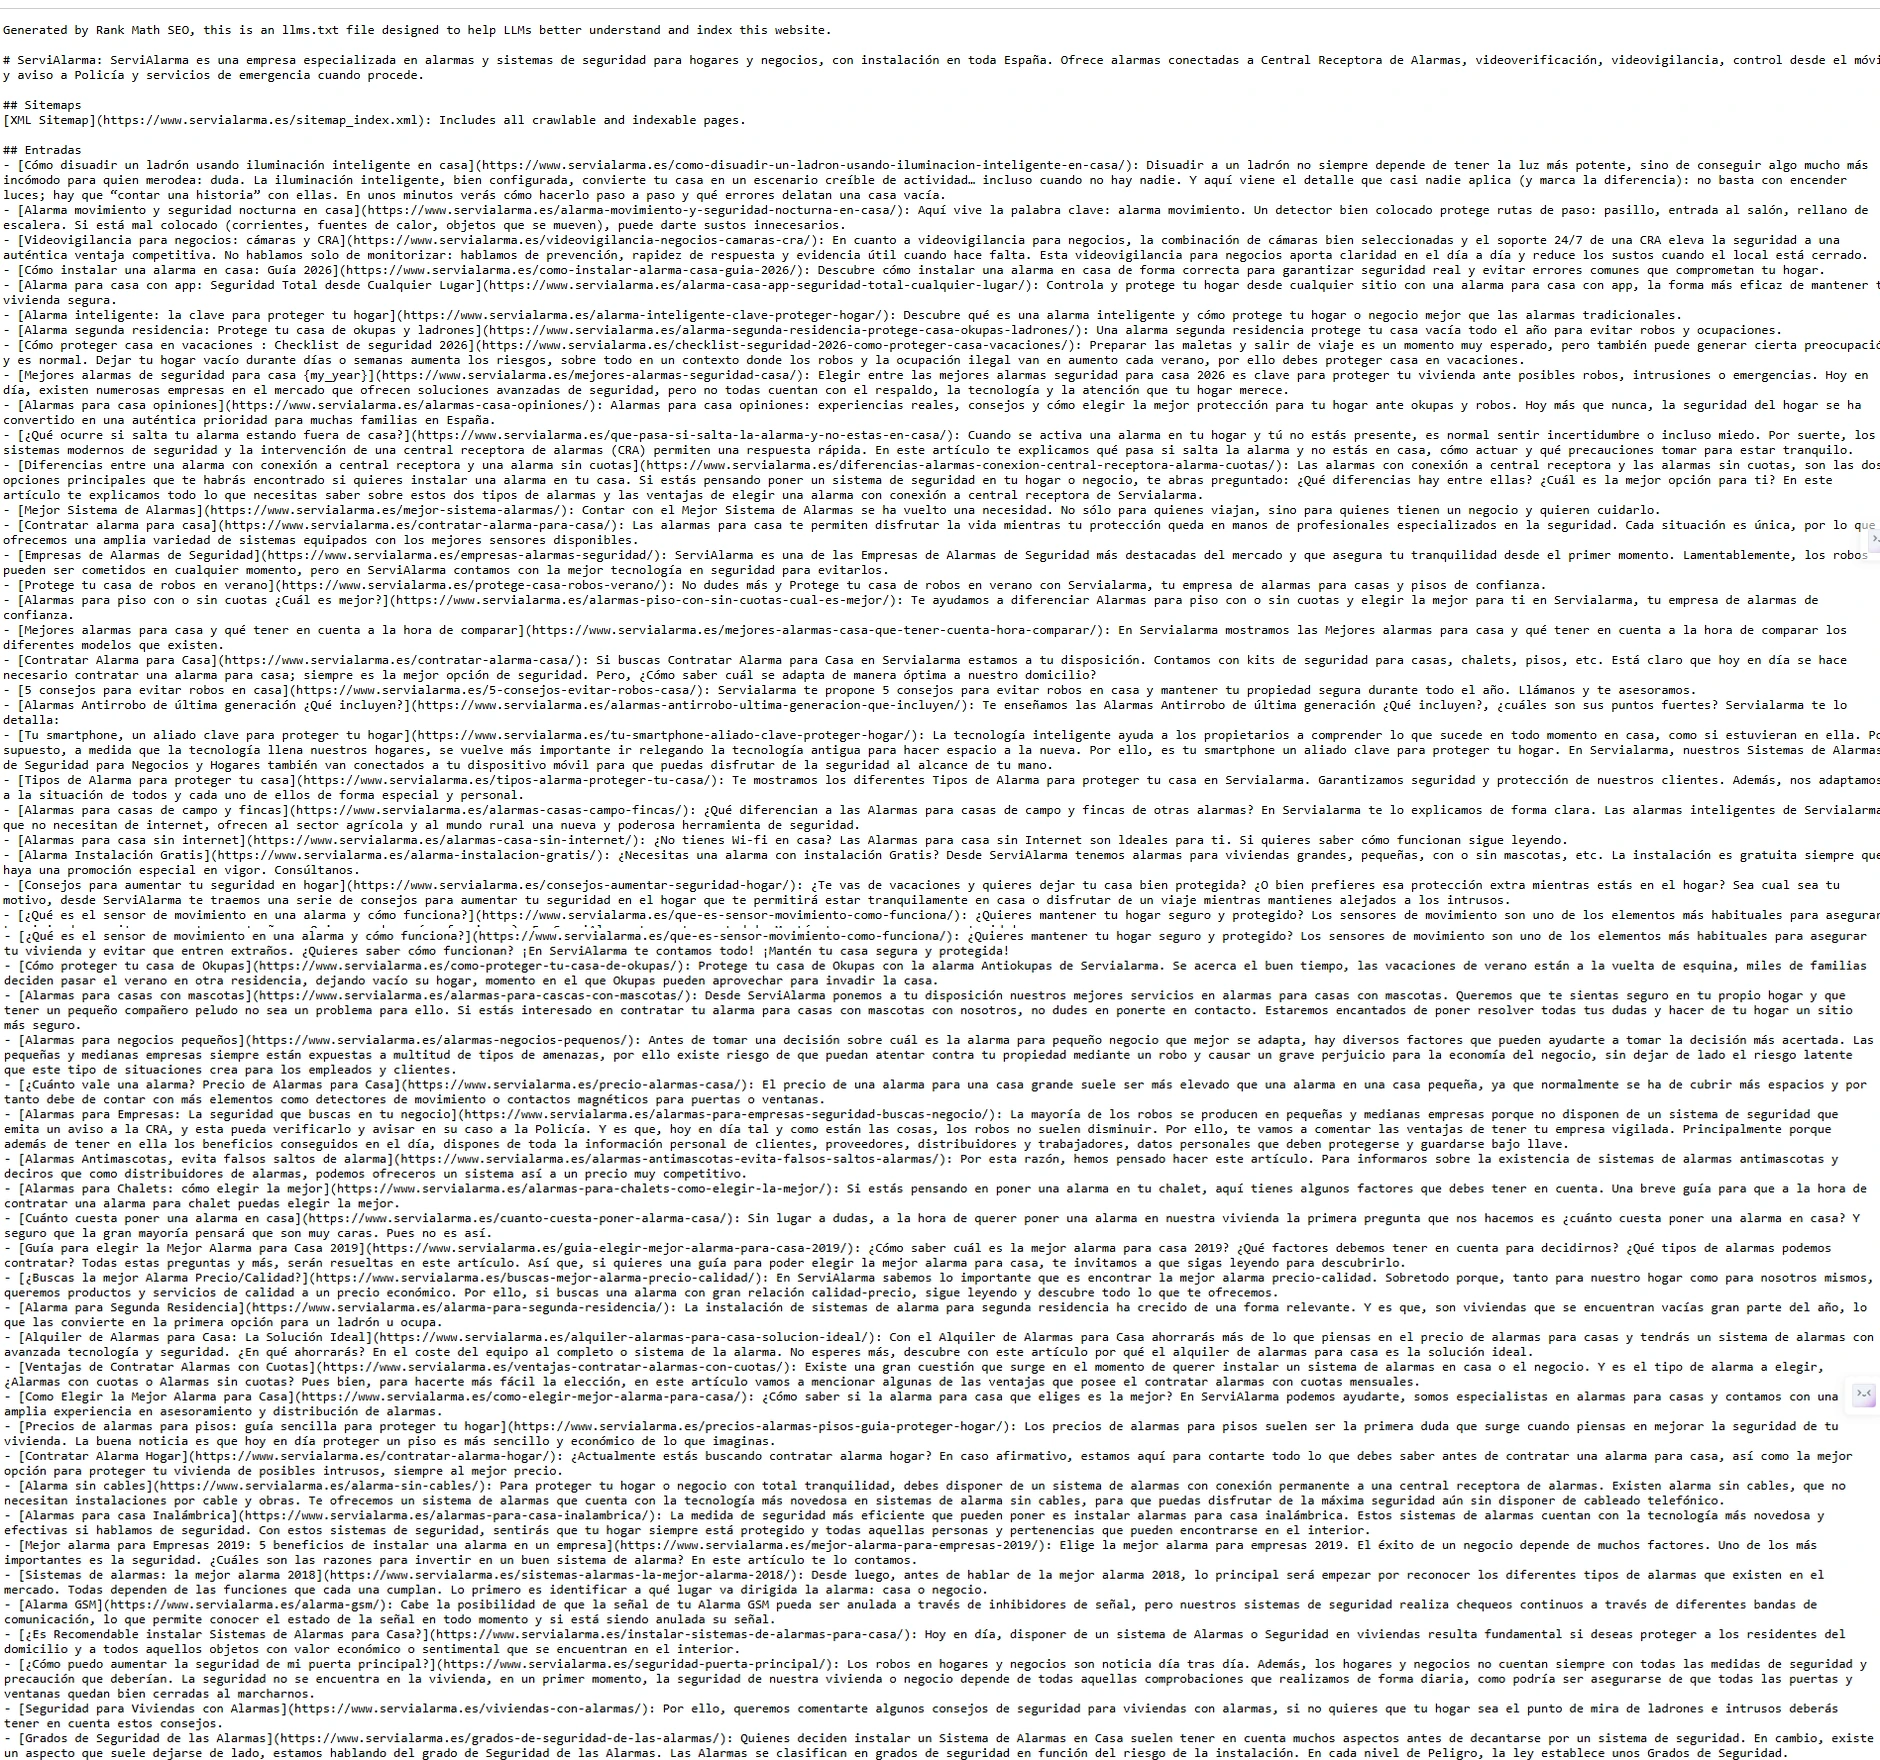
En nuestra implementación, el trabajo real no ha estado tanto en activar el módulo —que es inmediato— como en revisar qué post types y qué volumen de contenido tenía sentido incluir, dado que ServiAlarma cuenta con un número elevado de páginas locales con estructura similar entre sí.
Una precisión importante, para no llevar a equívoco: usamos ServiAlarma como ejemplo de implementación real, no como prueba de que llms.txt haya generado mejoras de tráfico, posiciones o menciones en sistemas de IA. No disponemos de datos que permitan atribuir ningún resultado de negocio a este archivo en concreto, y como se ha explicado a lo largo del artículo, hoy no existe forma de medir con fiabilidad cuántos sistemas de IA lo están consultando. Lo que sí podemos afirmar es que la implementación técnica está hecha, es funcional, y forma parte de cómo estamos preparando los proyectos de cara a un ecosistema de búsqueda que sigue cambiando.